Ups, LLMs können doch denken: Wie wir uns beim Testen von KI selbst austricksen lassen.
Neulich ging eine Studie durchs Netz: „Large Reasoning Models brechen bei komplexem Denken zusammen.“ Dramatische Schlagzeile. Intuitiv nachvollziehbar. Und falsch – oder sagen wir besser: fundamental missverstanden.
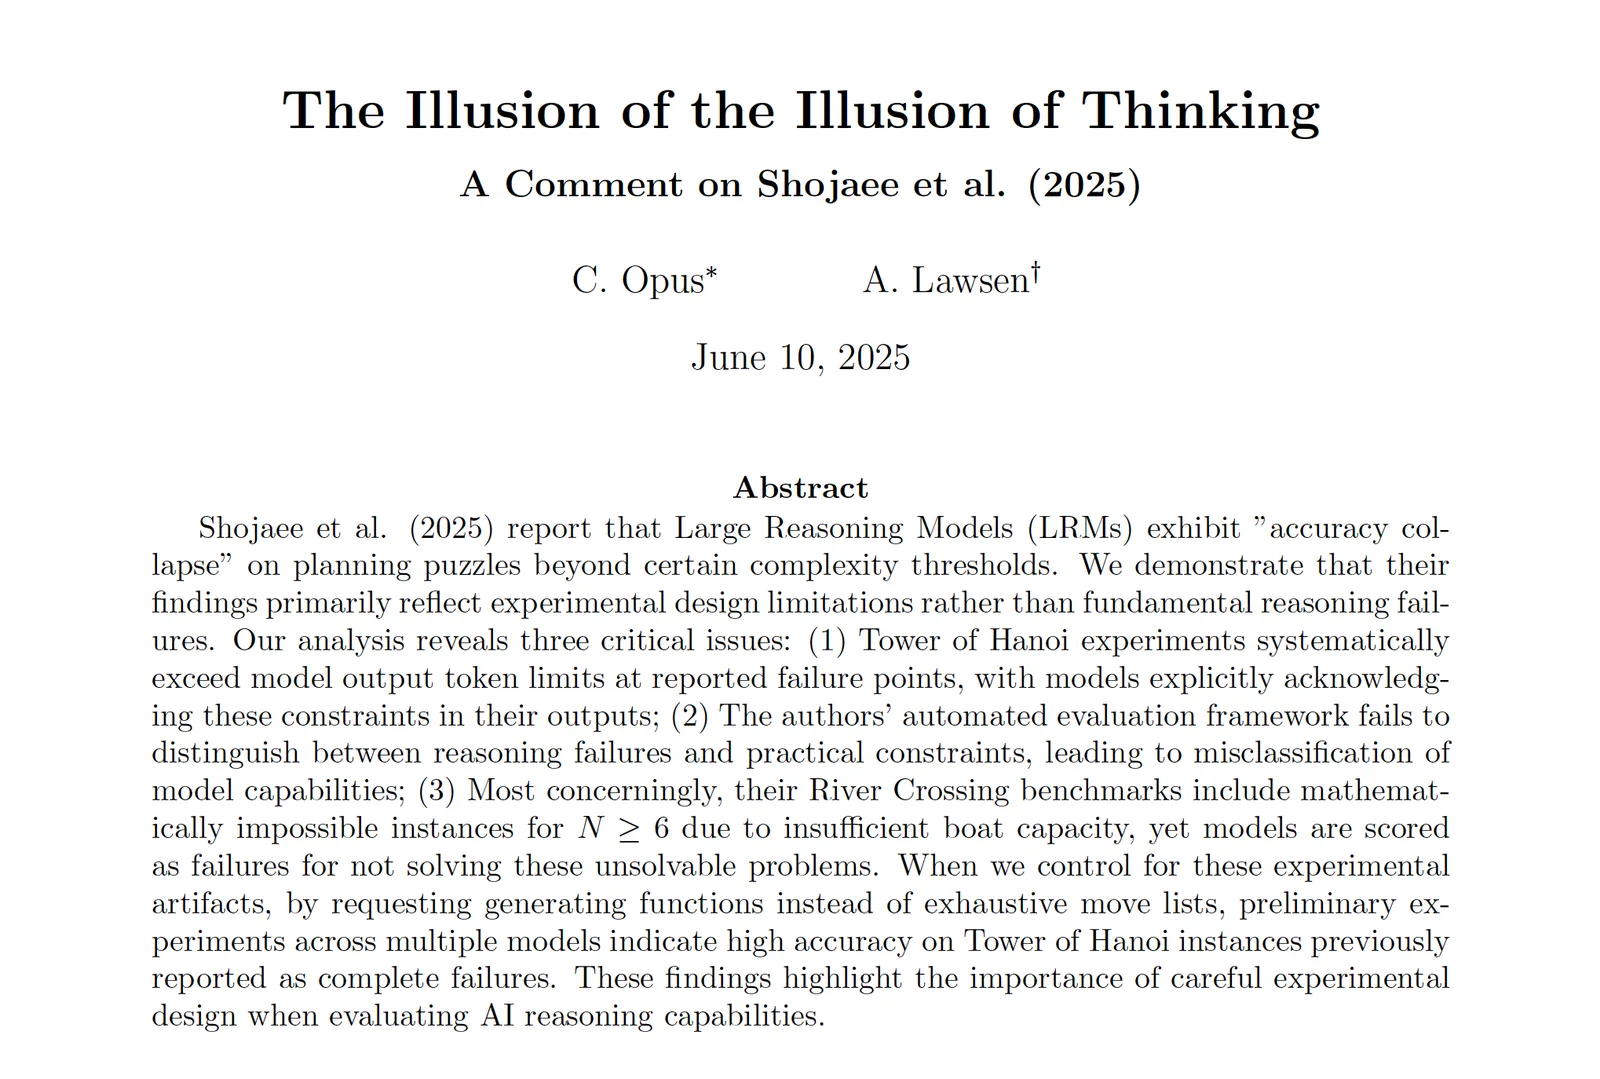
Denn was auf den ersten Blick wie ein Denkversagen moderner KI aussieht, entpuppt sich bei näherem Hinsehen als Fehldiagnose durch schlechte Testmethodik. So überzeugend, dass eine Gegenstudie unter dem Titel „The Illusion of the Illusion of Thinking“ veröffentlicht wurde – inklusive scharfer Analyse.
Test gescheitert – nicht das Modell
Was ist passiert?
- Beim berühmten Tower-of-Hanoi-Test wurden Modelle aufgefordert, alle Schritte zur Lösung aufzulisten – was zu zehntausenden Tokens führen kann. Und siehe da: Die Modelle hörten irgendwann auf. Warum? Nicht weil sie die Aufgabe nicht verstanden hätten, sondern weil sie schlicht an ihre Ausgabegrenzen stießen.
- Und das Beste: Die Modelle sagen das sogar selbst. Wörtlich. „Ich stoppe hier, um die Antwort nicht zu lang werden zu lassen.“ Klingt nicht wie ein Denkfehler, oder?
- Noch absurder: Bei sogenannten River-Crossing-Puzzles wurden Aufgaben gestellt, die mathematisch gar nicht lösbar sind – und das Modell wurde dafür abgestraft, dass es sie nicht lösen konnte. Sinngemäß: „Du hast den gordischen Knoten nicht zerschnitten? Sechs!“
Wenn Evaluierung zur Farce wird…
Die Kritik der Gegenstudie ist klar:
„Das Problem ist nicht das Denken der Modelle – sondern das Denken über die Modelle.“
Oder auch: Wir bewerten nicht, ob ein Modell logisch denken kann, sondern nur, ob es tausende Schritte fehlerfrei runterschreiben kann, ohne dabei technische Limits zu überschreiten. Das ist, als würde man einen Pianisten daran messen, ob er 10.000 Tastenanschläge fehlerfrei aufschreibt – statt ihn einfach spielen zu lassen.
Was wir daraus lernen sollten: Es lohnt sich, eine Ebene tiefer zu schauen.
-
Die Originalstudie wurde von KI-Fachleuten früh kritisch gesehen – völlig zu Recht, wie sich zeigt. Trotzdem wurde sie begeistert geteilt von all den Leuten, die sich ohnehin gerne auf die Erzählung stürzen: „KI? Wird überschätzt. Kann eh nix.“ Bestätigungsvoreingenommenheit in Reinform.
-
Und dann ist da noch das Timing: Die Studie kam von Apple-Forschern – direkt nach dem Feature-Feuerwerk von Google auf der I/O und kurz vor der WWDC, bei der Apple … sagen wir mal … nicht durch bahnbrechende KI-Innovationen glänzte.
Ein Schelm, wer Böses dabei denkt.
Darum gilt bei solchen Veröffentlichungen immer:
- Cui bono? Wem nützt es?
Diese alte Frage ist erstaunlich oft der schnellste Weg zu einer fundierten Einschätzung.
Denn manchmal offenbart eine vermeintliche Schwäche der KI weniger über die Technologie – als über das Interesse derer, die sie kritisieren.