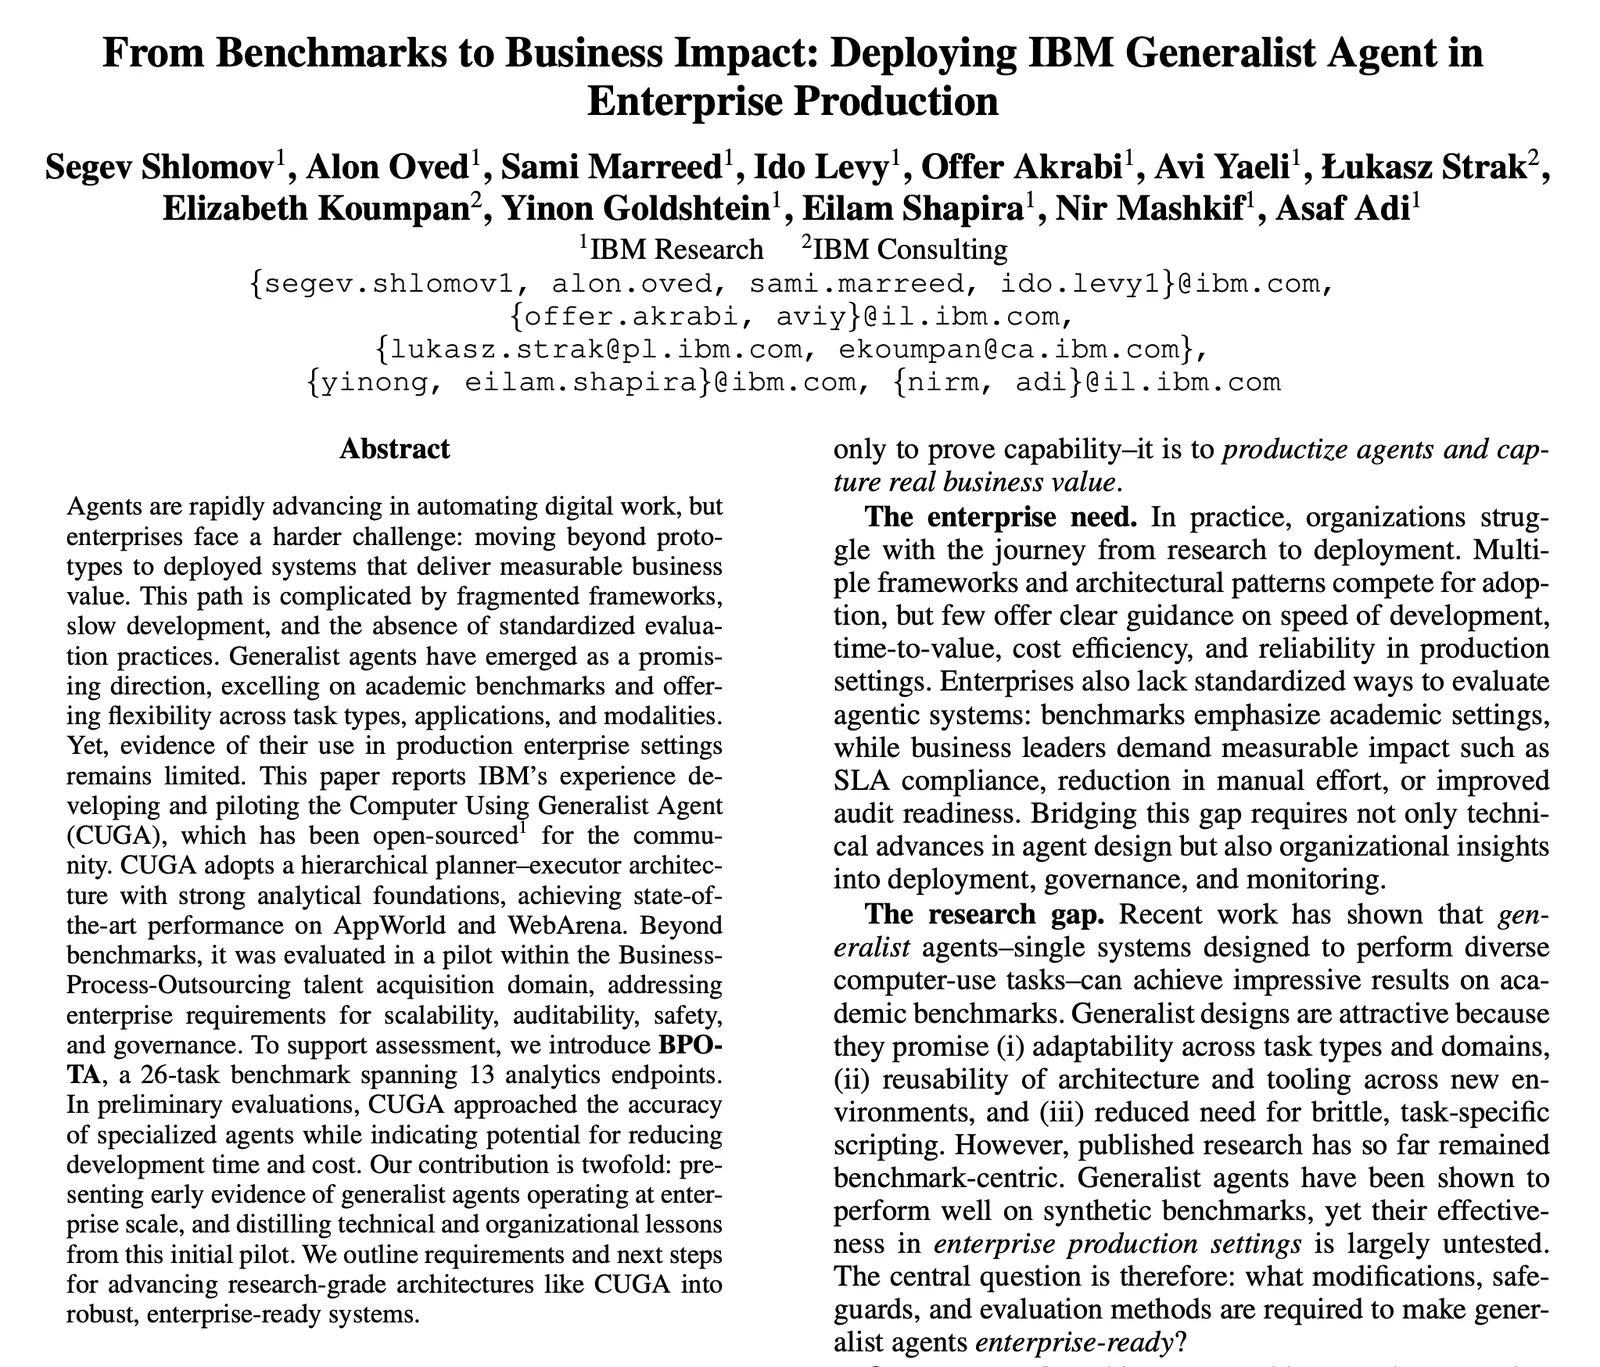
IBM-Studie ohne Marketing-BlaBla: Der Engpass bei KI-Agenten liegt nicht in den Modellen, sondern in Governance, Benchmarks und der Zusammenarbeit von Mensch und Agent.
Im Paper beschreibt IBM, wie ein Agent in einem realen BPO-Setting für Talent Acquisition getestet wurde. Dabei gab’s Erkenntnisse, die in den „Breaking“-Nachrichten über Agenten eher nicht auftauchen:
1⃣ Die Benchmarks der Fachabteilung sind wichtiger als die im KI-Testparcours
Auf AppWorld und WebArena liefert der Agent State-of-the-Art-Ergebnisse – trotzdem war das nur „nice to know“. Entscheidend wurde erst der eigens entwickelte Benchmark mit 26 realen Tasks:
- konkrete Fragestellungen aus dem Alltag von Recruitern und Analysten
- feste Testsets, klare Metriken (Accuracy, Latenz, Provenance)
- reproduzierbare Ergebnisse, die sich mit Business-Zielen verknüpfen lassen
Kurz: Ohne eigenen Fachbereichs-Benchmark gibt es keine seriöse Diskussion über Produktionsreife.
2⃣ Human-in-the-Loop (HITL) ist ein Steuerungsinstrument, kein Notnagel Der Agent wurde bewusst in einem read-only, HITL-Szenario betrieben:
- die Fachseite definiert, wo der Agent allein arbeiten darf
- wo er nur Analysen liefert
- und wo explizite menschliche Freigabe Pflicht ist
Damit wird HITL zu einem Governance-Werkzeug, vergleichbar mit Rollen- und Berechtigungskonzepten – nicht zu einer „Notbremse“, wenn etwas schiefgeht.
3⃣ Standards, Protokolle und Reproduzierbarkeit sind das eigentliche Skalierungsfundament
Der organisatorische Mehrwert entstand weniger durch „kreative Intelligenz“, sondern durch Struktur:
- ein zentraler API-/Tool-Hub mit einheitlichen Schemas
- konsequente Protokollierung sämtlicher Agentenschritte
- reproduzierbare Antworten mit klarer Herleitung und Daten-Provenance
Das macht Agenten revisionssicher, auditierbar und anschlussfähig an Compliance – und erst dadurch skalierbar über einen einzelnen Pilot hinaus.
4⃣ Produktivitätsgewinne sind real – aber an klare Rahmenbedingungen gebunden.
In den simulierten Workflows zeigen sich deutliche Effekte:
- Zeit-zur-Antwort von rund 20 Minuten manueller Analyse auf geschätzt 2–5 Minuten
- Reproduzierbarkeit der Antworten in Richtung ~95 %
- weniger „Spreadsheet-Wrangling“, mehr Zeit für Entscheidungen
Wichtig: Diese Ergebnisse gelten für klar abgegrenzte, gut modellierte Szenarien. Wer „Agenten überall“ ausrollt, wird diese Effekte nicht sehen.
Überraschend klar: Governance schlägt technische Machbarkeit
Obwohl der Agent technisch in der Lage ist, Browser und Systeme zu steuern, wurde diese Fähigkeit im Pilot bewusst deaktiviert - weil organisatorische Steuerbarkeit, Risiko und Nachvollziehbarkeit höher gewichtet wurden als maximale Automatisierung.
Die nächsten Fortschritte bei KI-Agenten in Unternehmen werden hiernach weniger von neuen Modellen abhängen, sondern von den Organisationen, die zuerst ihre Organisation konsequent auf Agenten-Use-Cases ausrichten – und damit bereit für belastbare Wertschöpfung machen.
From Benchmarks to Business Impact- Deploying IBM Generalist Agent in Enterprise Production